
Se hele arrangemenet i opptak
KI utvikles i raskt tempo
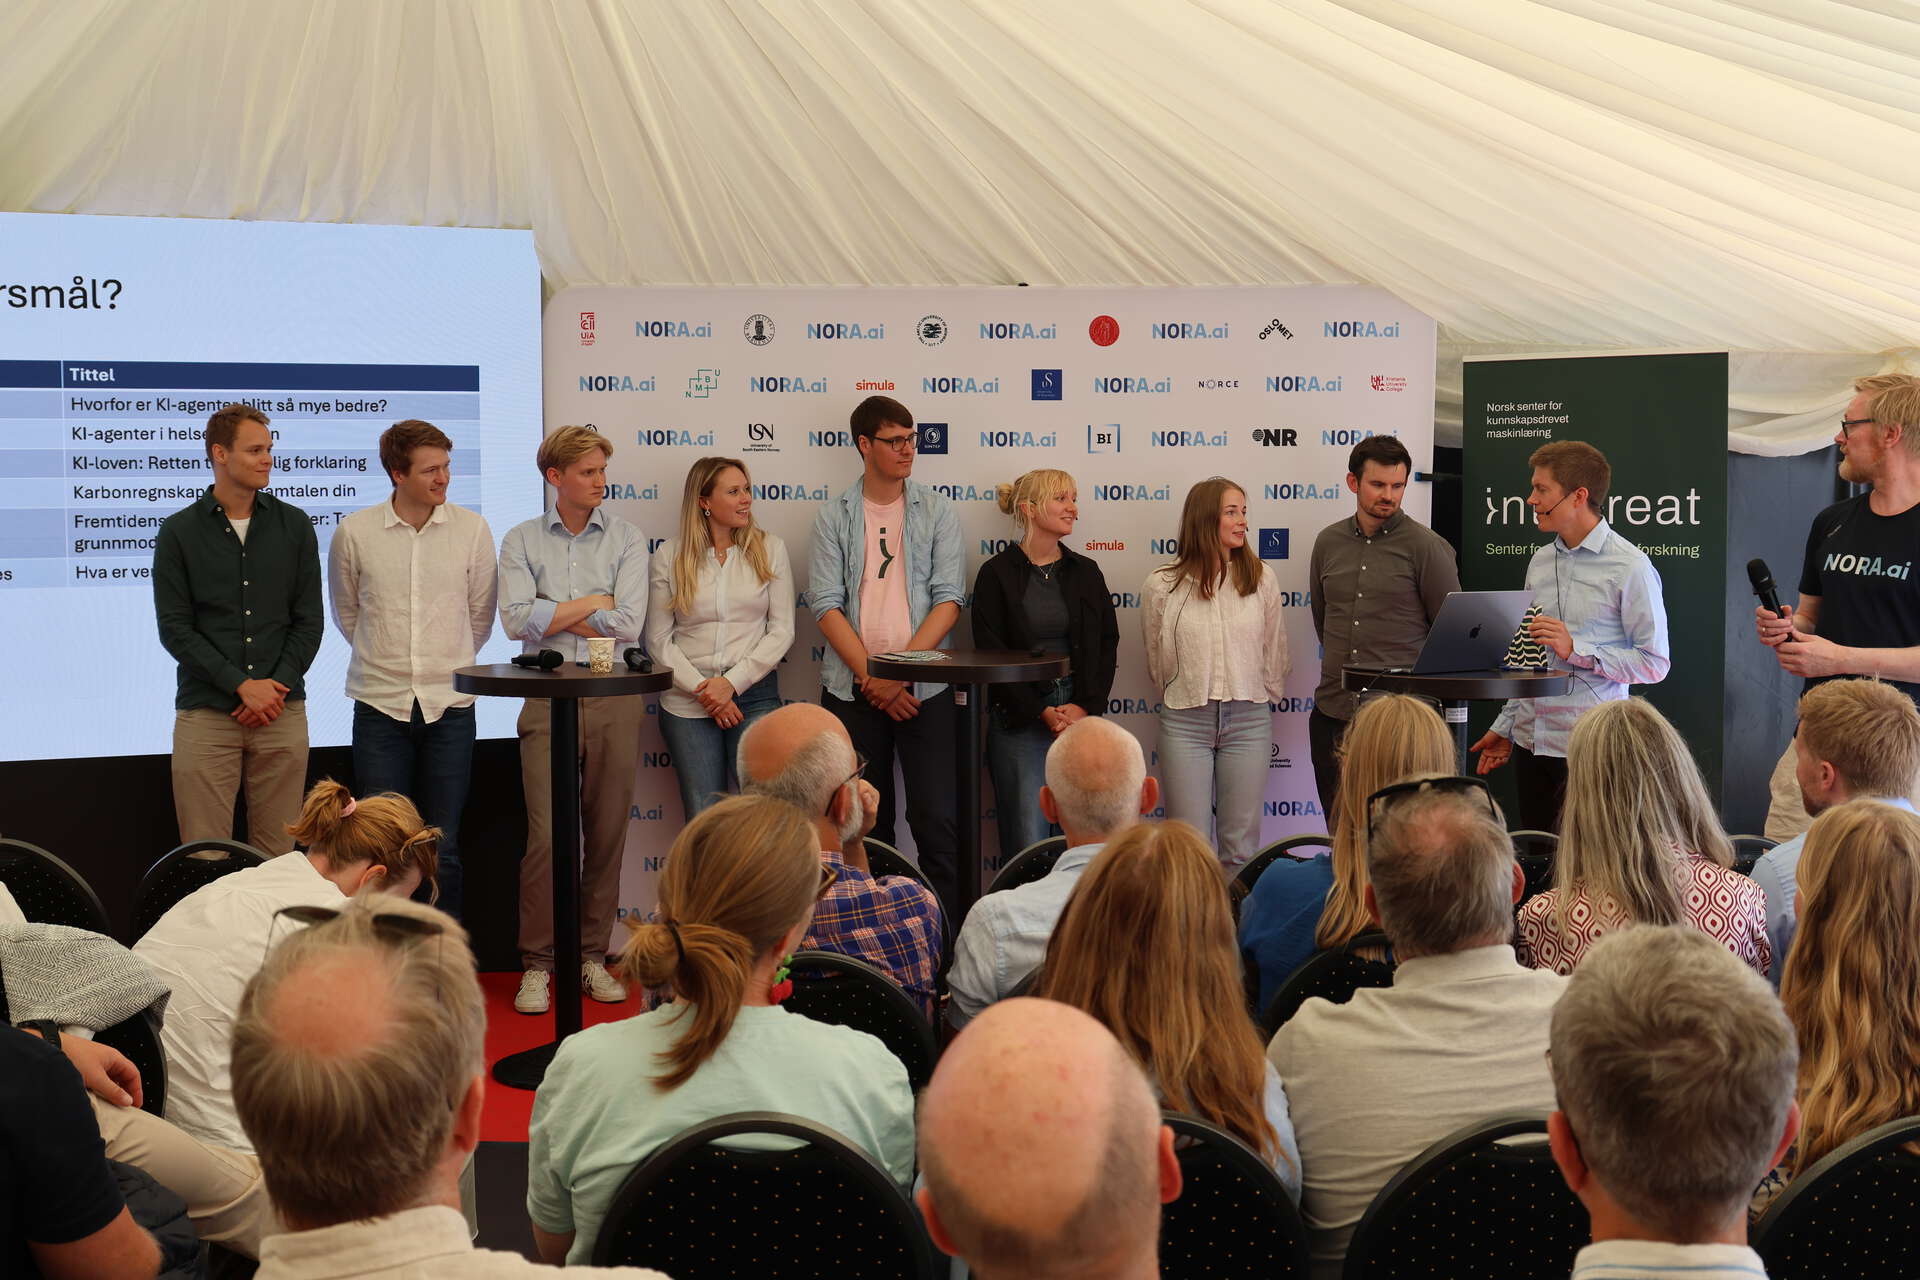
Kunstig intelligens utvikler seg i et tempo som gjør det krevende selv for fagfolk å holde oversikt. På Integreats arrangement under Arendalsuka fikk publikum derfor en lettfattelig oppdatering på utvalgte temaer fra forskningsfronten, formidlet av den kommende generasjonen KI-forskere.
I løpet av 45 minutter tok sju stipendiater og én postdoktor publikum gjennom noen av de mest aktuelle spørsmålene i KI-forskningen: Hvorfor har KI-agenter blitt bedre på kort tid? Hva kan de bety for helsetjenesten? Hva innebærer retten til en forklaring når KI tar beslutninger? Hvor stort er egentlig karbonavtrykket fra KI-bruk? Og kan tabulære grunnmodeller og verdensmodeller bli viktige byggesteiner i neste generasjon kunstig intelligens?
Ordstyrer og professor ved Universitetet i Oslo (UiO), Øystein Sørensen, åpnet arrangementet med å beskrive Integreats mål: å gjøre maskinlæring mer bærekraftig, pålitelig og etisk. Vertskap for senteret er UiO, UiT Norges arktiske universitet og Norsk Regnesentral.
Fra språkmodell til handlende agent
Først ut var Håkon Austlid Taskén, stipendiat ved Integreat og UiO, med en innføring i KI-agenter. En vanlig språkmodell svarer på spørsmål. En KI-agent gjør noe, forklarte han.
Agentenes gjennombrudd handler ikke bare om at modellene har blitt større og bedre trent. Minst like viktig er at de nå trenes på lengre oppgaver som krever mange handlinger etter hverandre, og at systemene rundt modellene har blitt bedre. De kan lage planer, følge sjekklister, oppdage feil og prøve igjen. Modellene gjør rett og slett flere handlinger etter hverandre uten å gjøre feil.
Det er nettopp kombinasjonen av bedre modeller, mer målrettet trening og smartere systemdesign som gjør at KI-agenter i dag kan løse oppgaver som for kort tid siden var utenfor rekkevidde.
KI i helsesektoren
Christoffer Lingjærde, stipendiat ved Integreat og Universitetet i Oslo, tok spørsmålet videre inn i helsesektoren. Der er behovet stort: Norge mangler allerede mange årsverk i helse- og omsorgstjenesten, og digitalisering og KI trekkes ofte frem som en del av løsningen.
Lingjærde beskrev hvordan en KI-agent i et journalsystem i prinsippet kan gjøre mer enn å skrive et godt avsnitt. Den kan hente labsvar, sjekke medisinlister, foreslå tiltak, bestille prøver og dokumentere i journalen. Men i det øyeblikket systemet går fra å lese og foreslå til å handle, blir spørsmålene langt mer alvorlige.
Journalen er et juridisk dokument. Dersom en KI-agent endrer den, må det være tydelig hvem som har ansvar, hvordan feil kan oppdages, og hvordan systemet kan testes i den virkelige verden. Lingjærdes poeng var at utfordringen ikke først og fremst er om teknologien finnes. Det er mange etiske sider ved dette som må grundig vurderes.
Når forklaringer ikke forklarer nok
Camilla Lingjærde, postdoktor ved Integreat og Universitetet i Oslo, snakket om KI-loven og retten til forklaring (eller retten til å gi en dårlig forklaring). Når KI brukes i beslutninger som påvirker enkeltmennesker, for eksempel i kredittvurderinger, ansettelser eller andre høyrisikoområder, er det ikke nok at systemet leverer en avgjørelse. Vi må også kunne forstå hvorfor, og kunne undersøke om beslutningen bygger på relevante og rettferdige kriterier.
Problemet er at mange avanserte KI-modeller fungerer som svarte bokser. Dersom treningsdataene er skjeve eller inneholder historiske forskjeller og fordommer, kan systemene videreføre eller forsterke dem. Det kan føre til diskriminering, også indirekte, ved at enkelte grupper systematisk får dårligere vurderinger eller færre muligheter. Forklaringsverktøy kan legges på i etterkant, men slike forklaringer kan være usikre og i noen tilfeller sprike fra hverandre. Da kan det være vanskelig å oppdage både feil, diskriminerende utslag og hvem som faktisk rammes, og retten til en "meningsfylt forklaring" kan bli svakere enn den høres ut.
Lingjærde pekte på behovet for tydeligere krav til hva en god forklaring skal inneholde, særlig i anvendelser der konsekvensene for mennesker er store. Det må også være mulig å kontrollere datagrunnlaget, teste systemene for skjevhet og oppdage om ulike grupper behandles ulikt. Hun fremhevet også gjennomsiktige modeller, altså modeller som i større grad kan forstås og etterprøves av mennesker, som et viktig alternativ i sensitive sammenhenger.
Karbonregnskapet bak KI-samtalen
Emil Poiesz og Sigurd Holmsen, begge stipendiater ved Integreat og Universitetet i Oslo, tok opp et spørsmål mange KI-brukere stiller seg: Hvor mye klimaskam bør vi ha for alle spørsmålene vi stiller språkmodeller?
For ett enkelt spørsmål kan utslippet være beskjedent. Poiesz viste til en måling der et KI-svar brukte 0,25 wattimer, tilsvarende omtrent seks centimeter kjøring med en ny bensinbil og langt mindre enn energibruken til en LED-lyspære over tid. Men det er bare én del av bildet.
Den store energibruken ligger i utvikling og trening av de største modellene. Holmsen forklarte hvordan modellene har vokst fra hundrevis av millioner til tusenvis av milliarder parametere, og hvordan bedre modeller fremdeles i stor grad krever mer data, mer regnekraft og mer strøm.
En enkelt KI-samtale er ikke nødvendigvis klimaverstingen i hverdagen, men den samlede infrastrukturen bak de største modellene er blitt en betydelig ressurs- og energidriver.
Tabulære grunnmodeller gir beslutningsstøtte
August Arnstad, stipendiat ved Integreat og Universitetet i Oslo, løftet frem en mindre kjent, men viktig del av KI-landskapet: prediktiv KI. Der generativ KI lager tekst, bilde, lyd, video og kode, brukes prediktiv KI til å forutsi, klassifisere og modellere.
Mye av samfunnet er bygget på tabulære data: rader og kolonner med informasjon om boliger, pasienter, kunder, økonomi eller tekniske systemer (f.eks excelark). Tradisjonelt har man laget egne modeller for hver oppgave og sektor. Det nye med tabulære grunnmodeller som TabPFN er at én ferdigtrent modell kan brukes på mange typer tabelldata uten at brukeren må bygge alt fra bunnen av.
Arnstad pekte på generalisering som nøkkelen. Hvis slike modeller kan overføre læring på tvers av ulike datatyper, kan de bli langt mer tilgjengelige beslutningsmotorer for både etablerte virksomheter og mindre aktører.
Kan KI lære mer enn språk?
Til slutt tok Hedvig Borgen Reiersrud og Berit Omli Øksnes, begge stipendiater ved Integreat og Universitetet i Oslo, publikum inn i forskningen på verdensmodeller.
Språkmodeller er trent på tekst og kan derfor skrive, kode og svare imponerende godt. Men verden består ikke av ord alene. Verdensmodeller forsøker å lære hvordan verden fungerer gjennom erfaringer, bevegelse, rom, handlinger og konsekvenser.
Reiersrud forklarte hvordan tidlige verdensmodeller kombinerte syn, hukommelse og handling, og hvordan slike modeller til og med kunne trenes i sin egen "fantasi". Øksnes beskrev tre viktige deler av feltet: modeller som lager visuelle verdener, simulatorer som forutsier neste tilstand i et miljø, og planleggere som foreslår hva en agent bør gjøre videre.
Feltet er fortsatt ungt, men interessen er stor. Dersom språkmodeller gir maskiner evne til å snakke om verden, kan verdensmodeller bli et steg mot systemer som i større grad kan forestille seg, resonnere om og samhandle med den.
Spørsmål fra salen
Etter presentasjonene spurte publikum blant annet om induksjon og deduksjon, hvor mye matematikk KI-forskere trenger, om avanserte modeller alltid er best, hvordan KI-agenter kan brukes trygt i helsetjenesten, og hvordan forskere bør bruke KI.
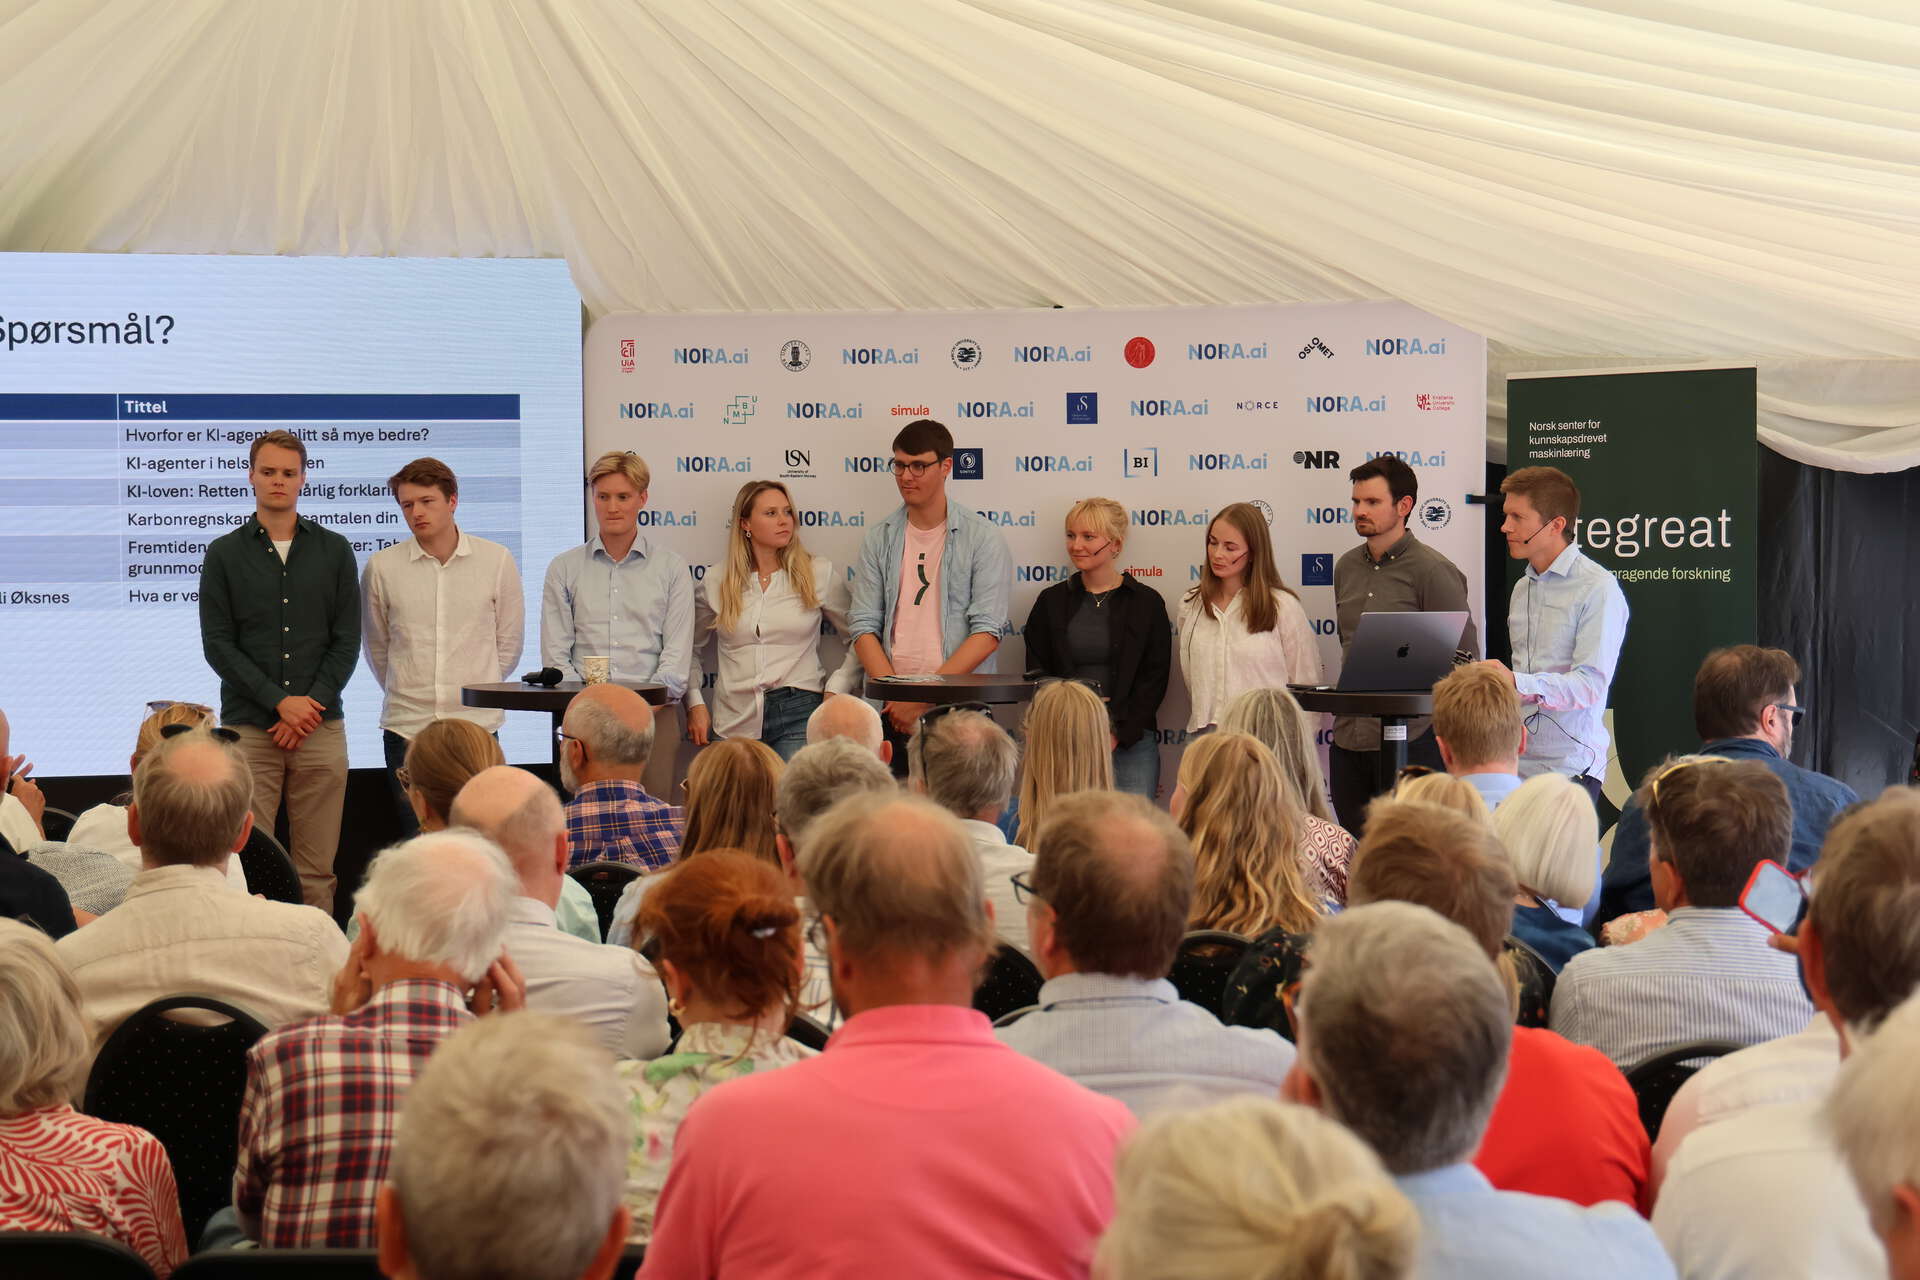
Takk til alle som deltok på arrangementet!